


검색되는 PDF의 글자층에서 한글이 지워지고 있었습니다
스캔과 이미지 변환이 따로 계산하던 OCR 글자층을 하나로 모으다가, 한글을 공백으로 바꾸는 조건을 찾았습니다. Pretendard를 PDFBox가 읽는 TrueType으로 바꿔 넣고, 생성한 PDF에서 한글 문장을 다시 읽었습니다.
들어가며
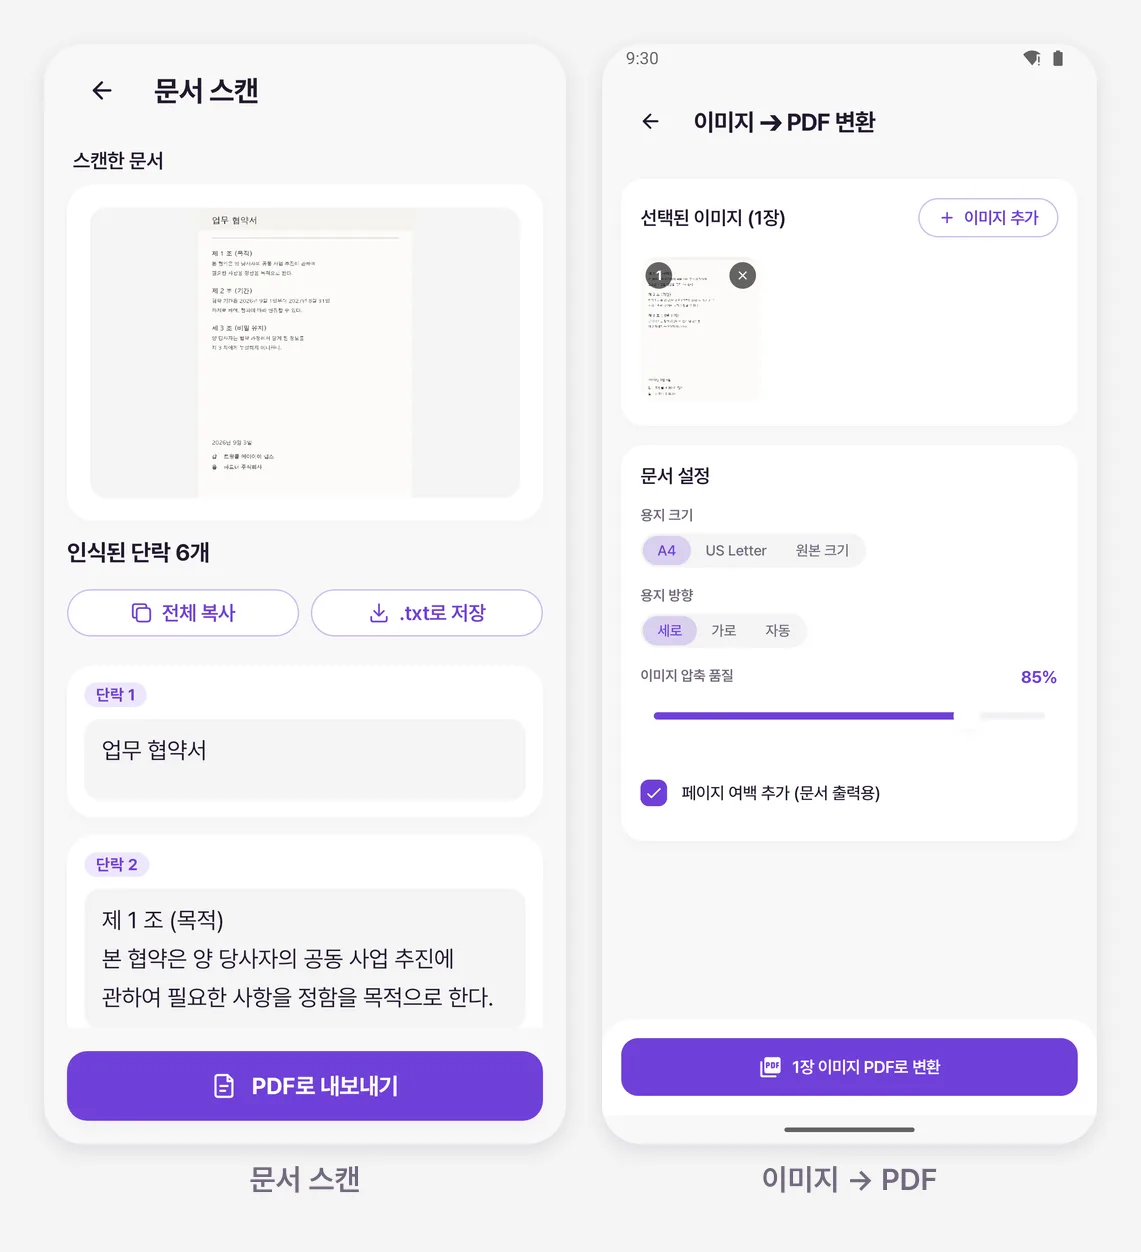
물타기 계산기를 Play 테스트 트랙에 올린 뒤 Pocket PDF를 만들기 시작했습니다. 카메라로 찍거나 불러온 문서를 PDF로 묶고, 사진 속 글자도 검색하고 복사할 수 있게 하는 앱입니다.
검색되는 PDF는 사진 위에 OCR이 읽은 글자를 보이지 않게 얹어서 만듭니다. 사진은 그대로 보이고, PDF 안에는 선택하거나 검색할 문자열이 들어갑니다. 이 글자층을 스캔과 이미지 변환이 함께 쓰도록 옮기다가, 한국어 검색이 처음부터 되지 않았다는 것을 알게 됐습니다.
두 경로의 좌표 계산을 하나로
스캔본은 PDF 페이지를 가득 채웁니다. 이미지 변환에서는 사진을 여백 안에 가운데 배치합니다. 그림의 위치와 크기는 달라도, OCR이 읽은 글자를 그림의 같은 자리에 놓는 계산은 같습니다. 그런데 그 계산이 스캔 쪽 SearchablePdfBuilder 안에만 있었습니다.
ML Kit에서 받은 문자열과 바운딩 박스는 이미지의 픽셀 좌표를 씁니다. 이를 PDF의 포인트 좌표로 바꾸고, 위에서부터 재는 이미지 좌표를 아래에서부터 재는 PDF 좌표에 맞춥니다. 이 계산을 InvisibleTextLayer로 꺼냈습니다.
이미지를 페이지 어디에 얼마나 크게 놓을지는 각 변환기가 정하고, InvisibleTextLayer에는 그 위치와 크기만 넘깁니다. 글자는 RenderingMode.NEITHER로 적어 화면에는 그리지 않습니다.
옮기다 읽은 조건 하나
코드를 옮기면서 sanitize 함수를 다시 읽다가 다음 조건을 발견했습니다.
ch.isLetterOrDigit() || ch.isWhitespace() ->
    sb.append(if (ch.code < 256) ch else ' ')
문자나 숫자를 처리하는 분기에서 코드값이 256 이상이면 공백을 넣고 있었습니다. 한글 음절은 U+AC00(44032)부터 시작합니다. 한국어 인식기가 한글을 읽어도, PDF에 넣기 전에 모두 공백이 되는 코드였습니다.
원인은 폰트였습니다. 글자층에 쓰던 PDType1Font.HELVETICA는 별도 파일 없이 쓸 수 있는 표준 폰트지만 한글을 담지 못합니다. 그 폰트가 처리하지 못하는 문자를 sanitize가 지우고 있었습니다. 원본 사진이 그대로 보이니 눈으로 PDF를 읽을 때는 아무 문제가 없었고, 그래서 아무도 몰랐습니다.
홈 화면은 «찍은 문서가 검색되는 깨끗한 새 문서로»라고 안내하고 있었습니다. 이 글자층으로는 그 안내대로 한국어 검색을 제공할 수 없었습니다.
Pretendard를 TrueType으로 바꿔 넣기
조건만 고쳐서 한글을 남기면 끝나는 문제가 아니었습니다. 남긴 글자를 PDF에 적으려면 한글 글리프를 가진 폰트가 필요했습니다.
앱은 이미 SIL Open Font License로 배포되는 Pretendard를 쓰고 있었습니다. 다만 저장소의 파일은 CFF 윤곽선을 담은 OTF였고, 당시 PDFBox의 PDType0Font에 넣는 경로는 TrueType의 glyf가 필요했습니다. tools/bake-ocr-font.py에서 필요한 글자만 남긴 뒤 CFF 곡선을 TrueType 곡선으로 옮겼습니다.
# tools/bake-ocr-font.py 중 윤곽선 변환 부분
pen = TTGlyphPen(None)
glyph_set[name].draw(
    Cu2QuPen(pen, CURVE_TOLERANCE, reverse_direction=True)
)
glyphs[name] = pen.glyph()
글자 범위는 앱이 쓰는 인식기(KoreanTextRecognizerOptions)가 읽는 문자를 기준으로 정했습니다. 한글 음절 11,172자에 기본 라틴·라틴-1·라틴 확장-A, 통화 기호, 문장부호, 호환 자모, 전각 문자를 더해 11,721자, 2.14MB가 됐습니다. 일본어·중국어 문서를 지원하려면 글리프만 더해서는 안 되고 인식기도 추가해야 합니다.
폰트와 문자 치환을 함께 바꿨습니다
InvisibleTextLayer는 새 폰트를 문서마다 한 번 읽습니다.
fun loadFont(context: Context, document: PDDocument): PDFont =
    try {
        context.assets.open(ASSET).use {
            PDType0Font.load(document, it, true)
        }
    } catch (_: Exception) {
        PDType1Font.HELVETICA
    }
마지막 true는 PDF에 사용한 글자만 포함하는 옵션입니다. 앱에 넣는 폰트는 2.14MB여도 문서마다 전체 파일을 복제하지는 않습니다.
기존의 문자 치환은 표준 폰트로 돌아간 경우에만 실행하도록 묶었습니다.
val latinOnly = font is PDType1Font
val sanitized = if (latinOnly) sanitizeToLatin(text) else text.trim()
새 폰트를 넣어도 이전 sanitize를 그대로 부르면 한글은 다시 공백이 됩니다. 폰트를 바꾼 만큼 이 분기도 바꿔야 했습니다.
생성한 PDF에서 문장을 다시 읽었습니다
pdfbox-android를 JVM에서 실행해 폰트 로딩, PDF 생성, 텍스트 추출을 확인했습니다. android.util.Log는 스텁을 두고 CMap 자원은 클래스패스에 올렸습니다. 확인에 쓴 문장은 다음과 같습니다.
계약서 임대차 보증금 ₩1,850,000 café
생성한 PDF는 약 4KB였고, /ToUnicode 매핑으로 되읽은 문장도 입력과 같았습니다. 한글뿐 아니라 원화 기호, 숫자, 악센트가 있는 라틴 문자까지 되찾았습니다.
마치며
두 경로를 하나로 모아 둔 덕분에 한글 처리도 한 곳에서 고칠 수 있었습니다. 각 변환기에는 페이지 안에서 사진의 자리를 정하는 일만 남았습니다.
여기까지는 JVM에서 확인한 것입니다. 실제 기기로 한국어 영수증을 찍고 뷰어에서 검색하는 시험과, 폰트를 못 읽었을 때 Helvetica로 돌아가는 경로를 실제로 통과시키는 시험은 당시 후속 작업으로 남겼습니다.